
Las pruebas que le hacemos a cada servidor antes de despacharlo
Un servidor refurbished no es un equipo usado que se limpia y se vende. Antes de salir de nuestro laboratorio pasa por un protocolo de 200 puntos de verificación y 72 horas de carga sostenida. Esta página explica en qué consiste, área por área, para que sepas exactamente qué estás comprando.
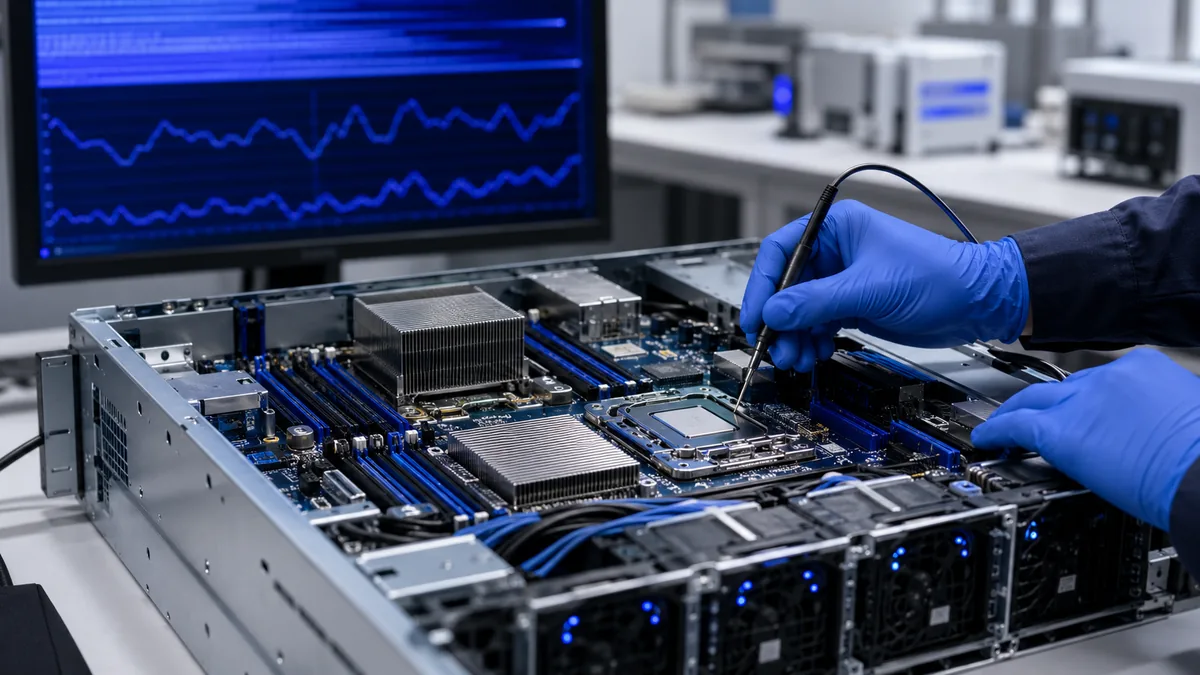
200
puntos de verificación
72 h
de burn-in bajo carga
0
equipos despachados sin aprobar
Los términos, en simple
Antes del detalle, qué significa cada cosa que vas a leer más abajo.
- Burn-in
- Someter el equipo a carga sostenida durante un período prolongado para provocar las fallas tempranas. La mayoría de los componentes electrónicos que van a fallar, fallan en sus primeras horas de operación: es la parte izquierda de la llamada curva de la bañera. Correr 72 horas de burn-in en laboratorio significa atravesar esa zona acá y no en tu datacenter.
- Test de estrés
- A diferencia del burn-in, que busca duración, el test de estrés busca el límite. Se lleva CPU, memoria, disco y red al máximo simultáneamente para verificar que el equipo sostiene su rendimiento sin errores, sin reinicios y sin throttling térmico, que es cuando el procesador baja su frecuencia para no sobrecalentarse.
- SMART
- Es el sistema de autodiagnóstico que traen los discos. Reporta horas encendido, ciclos de arranque, sectores reasignados y, en los SSD, cuánta vida de escritura les queda. Permite descartar un disco que todavía funciona pero ya está en cuenta regresiva.
- ECC
- Memoria con corrección de errores. Detecta y corrige la corrupción de bits que ocurre naturalmente en cualquier sistema. Es lo que separa una memoria de servidor de una de escritorio, y verificamos que esté activa y funcionando, no solo presente.
- iDRAC / iLO
- Los controladores de gestión remota de Dell y HPE. Permiten administrar el servidor aunque esté apagado. Guardan además el historial de eventos del equipo, que es la mejor fuente para saber qué vida tuvo antes de llegar a nosotros.
El protocolo, área por área
200 puntos de verificación repartidos en 12 áreas. Abajo están los que más pesan en cada una; el resto son comprobaciones de detalle dentro del mismo bloque.
Recepción e inventario
12 puntos- Verificación del número de serie y del service tag contra la documentación de origen
- Inspección física de chasis, rieles, tapa y conectores en busca de daño de transporte
- Confirmación de que la configuración recibida coincide con la declarada, componente por componente
+ 9 verificaciones adicionales en esta área
Placa base y arranque
18 puntos- POST completo y lectura de los códigos de diagnóstico de la placa
- Inspección de sockets, condensadores y conectores de alimentación
- Verificación de la batería CMOS y de que la configuración persiste tras un corte de energía
+ 15 verificaciones adicionales en esta área
Procesadores
16 puntos- Los procesadores se instalan según la configuración que pediste, así que cada equipo lleva pasta térmica nueva. Ninguno sale con el montaje del dueño anterior
- Detección de todos los sockets poblados, con modelo, frecuencia base y número de núcleos
- Temperatura en reposo y bajo carga, contrastada contra la especificación del fabricante
+ 13 verificaciones adicionales en esta área
Memoria
22 puntos- Detección de cada módulo con su capacidad, velocidad y rango
- Verificación de que ECC está activa y corrigiendo, no solo presente
- Test de patrones sobre el total de la memoria instalada, no sobre una muestra
- Distribución correcta por canal, que es de lo que depende el ancho de banda real
+ 18 verificaciones adicionales en esta área
Almacenamiento y controladora
30 puntos- Lectura SMART de cada unidad: horas encendido, ciclos, sectores reasignados y errores
- En los SSD, porcentaje de vida de escritura consumida
- Prueba de lectura y escritura sobre la superficie completa de cada disco
- Verificación de la controladora RAID, su caché y el estado de la batería o supercapacitor
- Prueba de cada bahía del backplane de forma individual
+ 25 verificaciones adicionales en esta área
Fuentes de poder
14 puntos- Prueba individual de cada fuente bajo carga
- Simulación de falla: se desconecta una fuente en caliente y se confirma que el equipo no se cae
- Medición de voltajes en los distintos rieles y verificación de los ventiladores internos
+ 11 verificaciones adicionales en esta área
Red
12 puntos- Prueba de enlace y transferencia en cada puerto, incluidos los de las tarjetas adicionales
- Verificación de la negociación de velocidad en todos los modos soportados
- Confirmación de que las direcciones MAC son válidas y persistentes
+ 9 verificaciones adicionales en esta área
Gestión remota
16 puntos- Acceso a iDRAC o iLO, verificación de licencia y de la interfaz web
- Lectura del registro histórico de eventos para reconstruir la vida previa del equipo
- Restablecimiento a valores de fábrica y borrado de credenciales del dueño anterior
- Confirmación de que los sensores de salud reportan correctamente
+ 12 verificaciones adicionales en esta área
Firmware y BIOS
10 puntos- Actualización de BIOS, controladora, backplane, red y gestión remota a la última versión estable
- Verificación de que todo el equipo queda en una línea base de firmware consistente entre componentes
+ 8 verificaciones adicionales en esta área
Térmica y ventilación
14 puntos- Prueba de cada ventilador de forma individual, con sus revoluciones y su respuesta a la curva
- Verificación de que no hay obstrucción en el flujo de aire ni disipadores con polvo
- Monitoreo térmico bajo carga para descartar puntos calientes
+ 11 verificaciones adicionales en esta área
Burn-in y estrés
24 puntos- 72 horas continuas de carga sostenida sobre procesador, memoria y almacenamiento en simultáneo
- Monitoreo de temperatura durante todo el período para detectar throttling térmico
- Ciclos de apagado y encendido en frío y en caliente
- Revisión de los registros al cierre: cualquier error corregido o evento anómalo detiene el despacho
+ 20 verificaciones adicionales en esta área
Limpieza y cierre
12 puntos- Limpieza interna completa del chasis y de los disipadores
- Borrado seguro de los discos y confirmación de que no queda dato del dueño anterior
- Etiquetado, registro del resultado del protocolo y sellado para despacho
+ 9 verificaciones adicionales en esta área
Qué pasa cuando un equipo no aprueba
No se despacha. Si un componente falla durante el protocolo se reemplaza y el equipo vuelve a empezar el burn-in desde cero, no desde donde quedó. Si la falla es del chasis o de la placa, el equipo sale del lote. Es la razón por la que un servidor recertificado con garantía no es lo mismo que un servidor usado.
Preguntas frecuentes
¿Cuánto dura el proceso completo por equipo?
El burn-in por sí solo toma 72 horas continuas. Sumando recepción, diagnóstico, reemplazos, actualización de firmware y validación final, el ciclo completo de un equipo toma varios días de laboratorio.
¿El protocolo es el mismo para Dell y para HPE?
Las áreas y los criterios son los mismos. Cambian las herramientas de diagnóstico y de firmware, porque cada fabricante tiene las suyas, y cambia el controlador de gestión remota: iDRAC en Dell, iLO en HPE.
¿Qué pasa con los datos del dueño anterior?
Los discos se borran de forma segura y la gestión remota se restablece a valores de fábrica, lo que elimina credenciales y configuración previa. Ningún equipo sale con información del propietario anterior.
¿Qué respaldo tengo si el equipo falla después de comprarlo?
La garantía. El protocolo es nuestro control interno para que el equipo no salga con problemas; la garantía es tu cobertura una vez que está operando. Cubre todas las partes y piezas por 1 año, ampliable a 3, con el despacho de los repuestos por nuestra cuenta.
¿Te quedó una duda del proceso?
Escríbenos y te responde alguien que conoce el laboratorio, no un formulario.